Durante años, gran parte del UX Research ha partido de una condición relativamente estable: diferentes participantes podían comportarse de forma distinta, pero interactuaban con versiones muy similares de un mismo producto.
La personalización está cambiando esa premisa.
Los sistemas de recomendación modifican qué contenido recibe cada persona y en qué orden, las interfaces adaptativas responden al contexto o al comportamiento, y los sistemas basados en IA pueden generar recomendaciones, respuestas o incluso elementos de la experiencia de forma dinámica.
Dos personas pueden utilizar el mismo producto y encontrarse con experiencias sustancialmente diferentes. Incluso una misma persona puede recibir mañana una experiencia distinta a la de hoy.
Esto plantea un reto metodológico para UX Research: ¿Cómo evaluamos una experiencia cuando la propia experiencia deja de ser un objeto de estudio estable?
La cuestión va más allá de Research. Si un equipo de producto no puede entender por qué una experiencia funciona para unas personas y no para otras, también resulta más difícil identificar el origen de la fricción, priorizar mejoras o determinar si la personalización está aportando valor real.
Cuando deja de existir una única experiencia de usuario
De una interfaz a múltiples experiencias
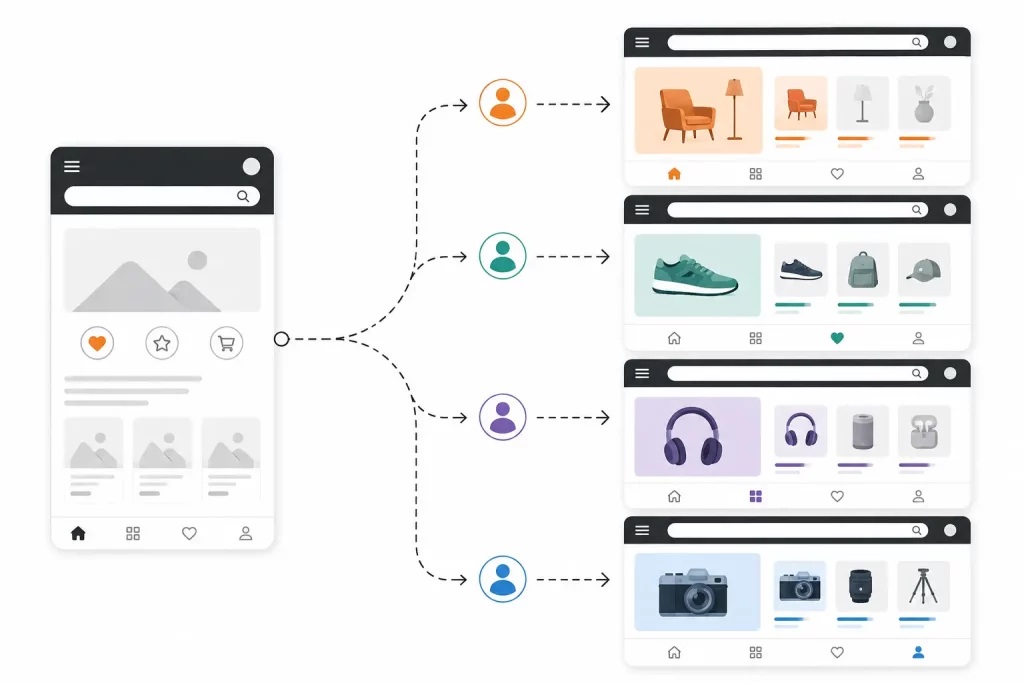
La personalización no es nueva. Los productos digitales llevan años adaptando contenido según preferencias, ubicación, historial de compra o comportamiento.
Lo que está cambiando es el grado, la granularidad y el dinamismo de esa adaptación.
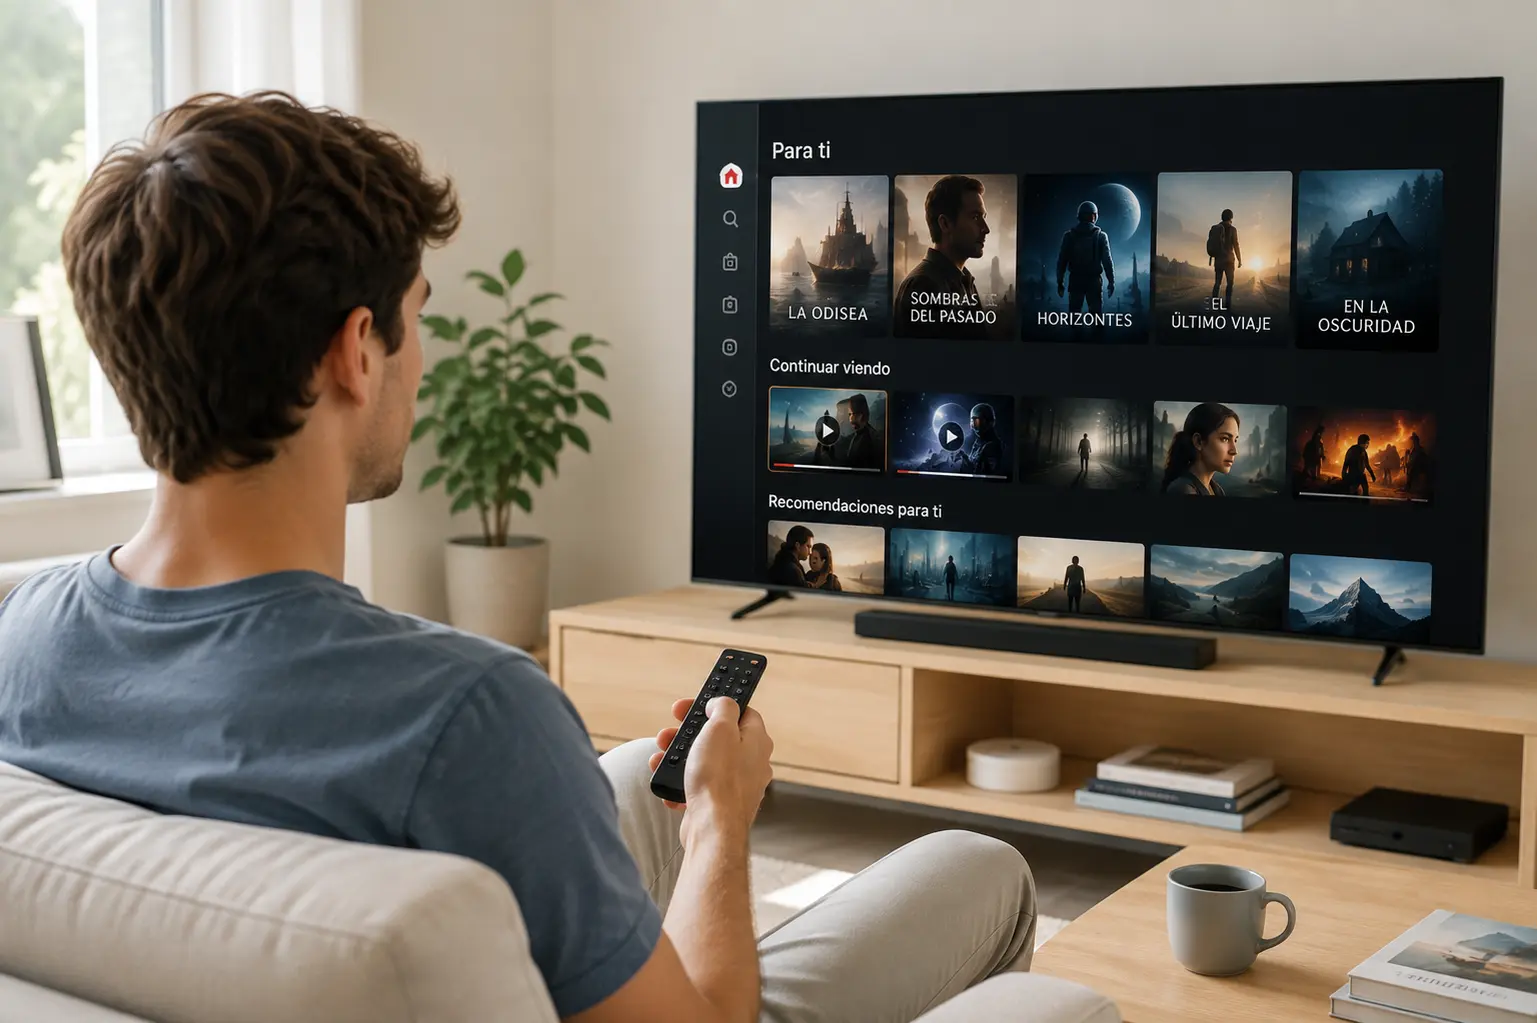
Una plataforma de streaming puede ordenar cientos de contenidos de forma diferente para cada persona; un ecommerce puede modificar recomendaciones y ofertas según señales de comportamiento; un producto financiero puede priorizar información a partir de patrones transaccionales; y la IA generativa añade otra variable: puede producir respuestas o contenidos que ni siquiera existían antes de iniciar la interacción.
Pasamos así de experiencias relativamente deterministas a espacios de experiencia con múltiples estados y recorridos posibles.
Para Research, esto introduce una nueva variable: ya no basta con observar qué hizo el participante, necesitamos comprender también qué experiencia recibió y por qué el sistema generó esa experiencia concreta.
De “¿puede utilizarlo?” a “¿se está adaptando bien?”
Las preguntas tradicionales de usabilidad siguen siendo imprescindibles: ¿La interfaz se entiende? ¿Puede completarse la tarea? ¿Dónde aparece la fricción?
Pero la personalización añade otra capa: ¿Está tomando el sistema buenas decisiones sobre qué mostrar, cuándo y a quién?
Una recomendación puede ser perfectamente comprensible y fácil de utilizar, pero completamente irrelevante. Del mismo modo, una recomendación muy pertinente puede estar integrada en una interacción confusa o inaccesible.
Por tanto, el objeto de evaluación se amplía: de la interfaz a la relación entre el comportamiento del sistema y las necesidades de la persona.
¿Qué significa que una personalización funcione bien?
Antes de medir la personalización necesitamos definir qué entendemos por calidad.
La relevancia es una dimensión evidente, pero no suficiente. Un sistema puede predecir correctamente que alguien volverá a seleccionar un determinado tipo de contenido y, aun así, no ayudarle a conseguir lo que necesita en ese momento. Los clics, compras, tiempo de permanencia o selecciones son observables. La intención, en cambio, suele ser inferida.
Por eso conviene diferenciar entre una personalización estadísticamente plausible y una personalización realmente útil.
La pregunta podría pasar de:
¿Hemos acertado con la recomendación?
a:
¿Esta adaptación ayuda a la persona a conseguir su objetivo con menos esfuerzo o a tomar una mejor decisión?
Y a esta dimensión habría que añadir otras como control, predictibilidad y transparencia. Una experiencia personalizada puede reducir esfuerzo cuando responde a las expectativas, pero generar fricción cuando la persona no comprende por qué algo ha cambiado, no puede corregir una inferencia incorrecta o deja de encontrar alternativas fuera de lo que el sistema ha seleccionado.
¿Qué se vuelve más difícil de evaluar?
Uno de los principios básicos de la investigación es la comparación. La personalización la complica porque los participantes pueden dejar de compartir el mismo estímulo.
Si una persona recibe cinco recomendaciones muy relevantes y otras cinco poco adecuadas, agregar sus resultados puede ocultar precisamente el hallazgo más importante: el sistema está produciendo niveles muy diferentes de calidad de experiencia.
Esto no impide comparar, pero cambia qué comparamos.
| Antes poníamos el foco en… | En experiencias personalizadas añadimos… |
| ¿Puede completar la tarea? | ¿La adaptación facilita conseguir el objetivo? |
| ¿Entiende la interfaz? | ¿Entiende también el comportamiento del sistema cuando es necesario? |
| ¿Dónde encuentra fricción? | ¿La fricción procede de la interacción o de la personalización? |
| ¿Qué hacen los participantes? | ¿Qué experiencia recibió cada participante y por qué? |
| Promedios de éxito o satisfacción | Variabilidad entre personas, cohortes y contextos |
| Un momento concreto de uso | Cómo evoluciona la experiencia con el tiempo |
Esta distinción es especialmente importante para separar calidad de interacción y calidad de personalización.
Si no identificamos qué capa está generando el problema, podemos terminar rediseñando una interfaz para intentar solucionar un problema del modelo, o ajustando el sistema de personalización para compensar un problema de interacción.
Además, aparece otra dificultad: el estado del sistema pasa a formar parte del contexto de investigación.
Lo que alguien ve puede depender de búsquedas anteriores, compras, contenidos ignorados, ubicación, preferencias explícitas o múltiples señales de comportamiento. Saber que una persona no encontró una opción puede no ser suficiente; necesitamos comprender por qué el producto decidió priorizar las opciones que le mostró.
Medir experiencias personalizadas
La task completion rate seguirá siendo útil, pero puede resultar insuficiente.
Imaginemos dos personas reservando un alojamiento: Ambas completan la reserva, la primera encuentra rápidamente una opción que responde a sus necesidades, la segunda descarta recomendaciones irrelevantes, corrige filtros varias veces y finalmente acepta una alternativa razonable.
Desde la métrica de finalización, ambas experiencias son un éxito. Desde UX, claramente no son equivalentes.
La personalización obliga a incorporar la calidad del resultado, no únicamente su consecución.
Dependiendo del producto, podríamos observar:
- relevancia percibida;
- esfuerzo necesario para alcanzar el objetivo;
- número de correcciones o reformulaciones;
- confianza en la decisión;
- predictibilidad del sistema;
- percepción de control;
- calidad del resultado;
- aceptación o rechazo de recomendaciones.
Pero tampoco deberíamos sustituir un promedio por otro. Las métricas agregadas pueden esconder grupos para los que la experiencia funciona sistemáticamente peor. Una tasa media de conversión o aceptación puede parecer positiva mientras determinadas cohortes reciben recomendaciones significativamente menos útiles.
La pregunta relevante pasa a ser:
¿Para quién funciona la experiencia, bajo qué condiciones y dónde se concentra la variabilidad?
Aquí UX Research, Product Analytics y Data Science empiezan necesariamente a encontrarse.
Repensar los métodos de UX Research
No necesitamos sustituir los métodos actuales, sino ampliar cómo los utilizamos y combinamos.
El reclutamiento necesita nuevas variables
Dos participantes demográficamente similares pueden recibir experiencias completamente diferentes debido a su historial de comportamiento.
Además de edad, ubicación o perfil socioeconómico, puede ser necesario considerar variables conductuales o experienciales: usuarios nuevos frente a recurrentes, diferentes niveles de historial disponible, personas que aceptan o corrigen frecuentemente recomendaciones, o distintos grados de familiaridad con el sistema.
Necesitamos capturar el estado que generó la experiencia
Aquí aparece uno de los retos metodológicos más relevantes: la reproducibilidad.
Si hoy observamos una recomendación problemática, ¿podremos reproducir mañana las condiciones que la generaron?
Dependiendo del producto, una sesión de investigación podría necesitar registrar no solo pantallas, sino también elementos como:
- estado relevante del sistema;
- historial de interacción;
- señales que influyeron en la adaptación;
- contenido o recomendación mostrada;
- versión del modelo o experimento, cuando sea relevante.
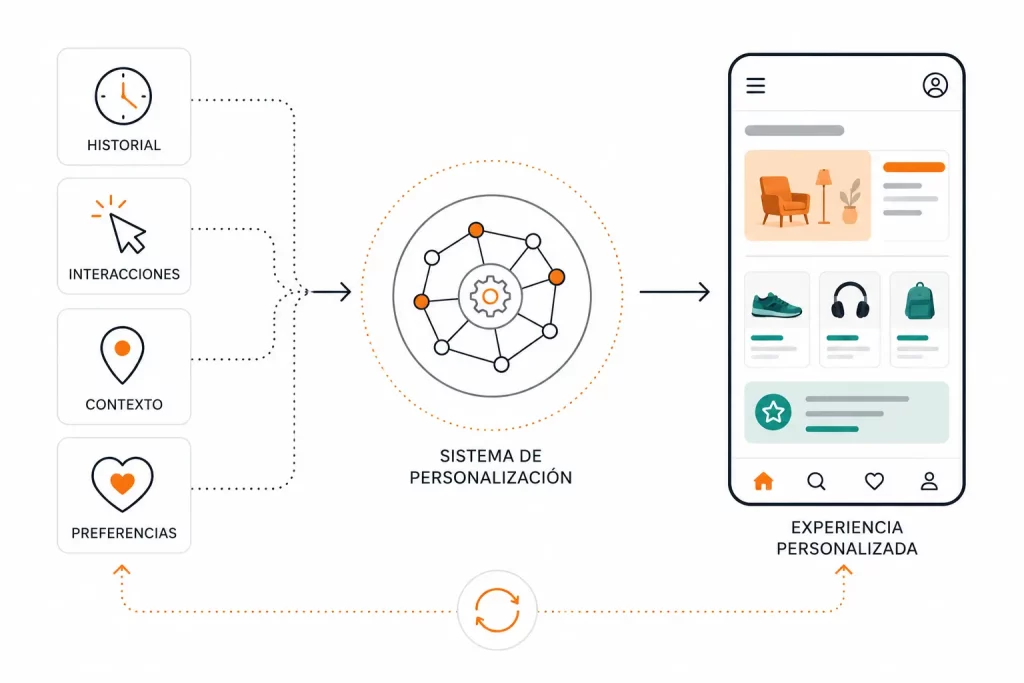
UX Research no necesita convertirse en ingeniería de Machine Learning, pero sí puede necesitar suficiente trazabilidad para conectar la evidencia de experiencia con el comportamiento del sistema.
Combinar evidencia cualitativa y comportamental
La complementariedad entre métodos se vuelve especialmente valiosa.
Analytics puede mostrar que una cohorte ignora repetidamente determinadas recomendaciones. La investigación cualitativa puede ayudarnos a entender si son irrelevantes, repetitivas, poco comprensibles o simplemente innecesarias.
Podemos pensar en un ciclo:
Señal de comportamiento → investigación cualitativa → hipótesis → experimentación → validación
Esto desplaza el Research desde estudios aislados hacia un sistema de evidencia más continuo.
Investigar también la evolución en el tiempo
La personalización introduce además una variable que un usability test puntual difícilmente puede capturar: el tiempo.
Una recomendación inicialmente poco útil puede mejorar cuando el sistema aprende, y una experiencia inicialmente relevante puede volverse repetitiva si la personalización termina reforzando demasiado el comportamiento pasado.
Diary studies, entrevistas recurrentes, cohortes de comportamiento o experience sampling pueden ayudar a investigar cómo evoluciona la relación entre persona y sistema.
Research, experimentación y analítica empiezan a converger
Cuando el producto cambia continuamente, una validación puntual ofrece necesariamente una fotografía parcial.
Esto no significa que todo Research deba ser continuo. Significa que podemos empezar a pensar en la evaluación como una capacidad continua del producto, no únicamente como un evento previo al lanzamiento.
La experimentación permite observar efectos causales a escala. La investigación cualitativa aporta algo diferente: entender cómo se experimentan esos efectos y por qué ocurren.
Un A/B test puede demostrar que un sistema de recomendación aumenta la conversión. Por sí solo no explica si las personas encontraron mejores opciones, si la mayor prominencia de las recomendaciones condicionó su elección o si disminuyó su confianza en la decisión.
Del mismo modo, una entrevista puede identificar un patrón relevante sin decirnos cuánto se extiende entre la población.
La oportunidad está en conectar ambos tipos de evidencia para responder no solo:
¿Qué versión funciona mejor?
sino:
¿Para quién funciona mejor, por qué, bajo qué condiciones y con qué trade-offs?
Y a medida que la personalización incorpora más IA, la evaluación automatizada tendrá también un papel creciente, pero el rendimiento del modelo y la calidad de la experiencia no son equivalentes.
Una recomendación puede ser estadísticamente relevante y resultar inadecuada en contexto; una respuesta generada puede ser correcta y llegar en un momento poco oportuno; una adaptación puede reducir clics y, al mismo tiempo, hacer el sistema menos predecible.
La evaluación humana sigue siendo necesaria para comprender significado, contexto, expectativas y consecuencias.
Un nuevo papel para UX Research
La interfaz sigue siendo importante, pero cada vez puede representar más el resultado visible de un sistema compuesto por datos de comportamiento, reglas, experimentos, modelos y lógica adaptativa.
Esto amplía el objeto de UX Research. No significa convertir Research en Data Science o evaluación de modelos, sino comprender la relación entre personas y productos.
Lo que cambia es la escala de esa relación: el objeto de investigación puede dejar de ser únicamente una interfaz relativamente estable para convertirse también en un sistema que decide qué experiencia crear, para quién y bajo qué condiciones.
Por eso, quizá una de las preguntas más útiles para evaluar productos personalizados sea:
¿Para quién funciona esta experiencia, bajo qué condiciones, por qué funciona y qué ocurre a medida que el sistema evoluciona?
Responderla requiere combinar usabilidad, investigación cualitativa, datos de comportamiento, experimentación y análisis longitudinal.
Para UX Research supone algo más que incorporar nuevas técnicas, también supone ampliar la disciplina para poder generar evidencia sobre productos cuyo comportamiento varía entre personas y cambia con el tiempo.
Y a medida que la personalización y la IA hagan esos productos más dinámicos, entender esa variabilidad puede convertirse en una de las aportaciones más relevantes de UX Research a las decisiones de producto.
En GammaUX ya estamos trabajando sobre estos retos junto a equipos de producto, combinando investigación, datos de comportamiento y evaluación continua para entender cómo funcionan las experiencias personalizadas, para quién aportan valor y qué evidencia necesitamos para seguir mejorándolas.